我存了这么多资料,怎么让AI自己去找?
今年以来,我陆续存了很多文档、文章和笔记,也让AI帮我做了不少项目。做的事情多了,这些项目和资料也就散在不同地方,用不同方式保存着。等到做独立站内容、处理运营问题,或者接着做旧项目时,我又得先把相关资料找回来。
我之前会把这些内容手动整理到一份Markdown文档里,然后让AI先去读这份文档。但是后来我发现,这个办法实在太麻烦,也很难一直维护下去。
所以我就开始琢磨,能不能用知识库来帮我检索以前的对话、跟我有关的信息,还有平时积累的知识和项目记录。我想让AI在继续做一件事时,先把需要的资料找出来,不用每次都由我先整理一份文档给它读。
想自己搭,可以先复制这段Prompt
如果你只想先搭一个自己的知识库,可以直接复制下面的完整Prompt,交给能操作本机文件的AI工具,不必先读完后文。它会先确认安装意愿、检测硬件,再根据你的电脑和资料选择模型,完成安装、建库和验收。
这段Prompt适合OpenCode、Codex CLI或Claude Code,也就是能读写本机文件、运行命令的AI编程工具。它会用到Ollama,这是在本机运行模型的软件。
这段Prompt用于搭建本机文字知识库,让AI能查询已有资料,并在文件新增或修改后更新索引。
用中文提问,怎么找到英文资料?
我之前让AI试检索时,其中一道题想找的是GPT-4o那次过度迎合用户的复盘,中文问法是:
之前那个越聊越迎合人的4o出了什么问题,OpenAI是怎么纠正的?
那次指定要找的资料,是我已经保存的OpenAI官方复盘。完整文件名是:
2025-04-29 Sycophancy in GPT-4o: What happened and what we’re doing about it.txt
这里的Sycophancy就是“过度迎合、谄媚”的意思。
但是这道题用的是“越来越迎合人”这个中文说法,没有填Sycophancy。只看这份英文文件名,区别就出来了:
| 我想到的词 | 这份文件名里有吗 | 按文件名能做什么 |
|---|---|---|
| 迎合、拍马屁 | 没有 | 只用这两个中文词匹配文件名,不会命中这份目标文件 |
| 4o | 有 | 可以用来找模型相关文件,但哪篇在讲过度迎合,还要继续判断 |
| Sycophancy | 有 | 如果已经知道这个英文词,直接搜文件名就很好用 |
记得4o、Sycophancy这些词时,我照样可以直接搜文件名。但是搜到模型相关文件后,还得继续看正文,判断哪篇在回答“为什么越来越迎合人、后来怎么处理”这个问题。
知识库会根据这个问题去匹配已入库的相关内容,不要求文件名里出现同样的中文字。那次查询返回的第一条,就指向这篇复盘,记录里还带着文件位置和片段编号。
原文开头写了回滚那次GPT-4o更新,后面还谈到训练、系统提示和用户反馈怎样调整。我想继续核对处理方式,就可以顺着结果回到这份原文,不只停在一串文件名上。
文件名搜索按名字里的词找,语义检索则按问题去匹配已收录的内容,把相关材料和出处一起带回来。我不必先把中文里的“迎合”换成Sycophancy,才能开始找这件事的资料。
知识库和普通搜索,有什么区别?
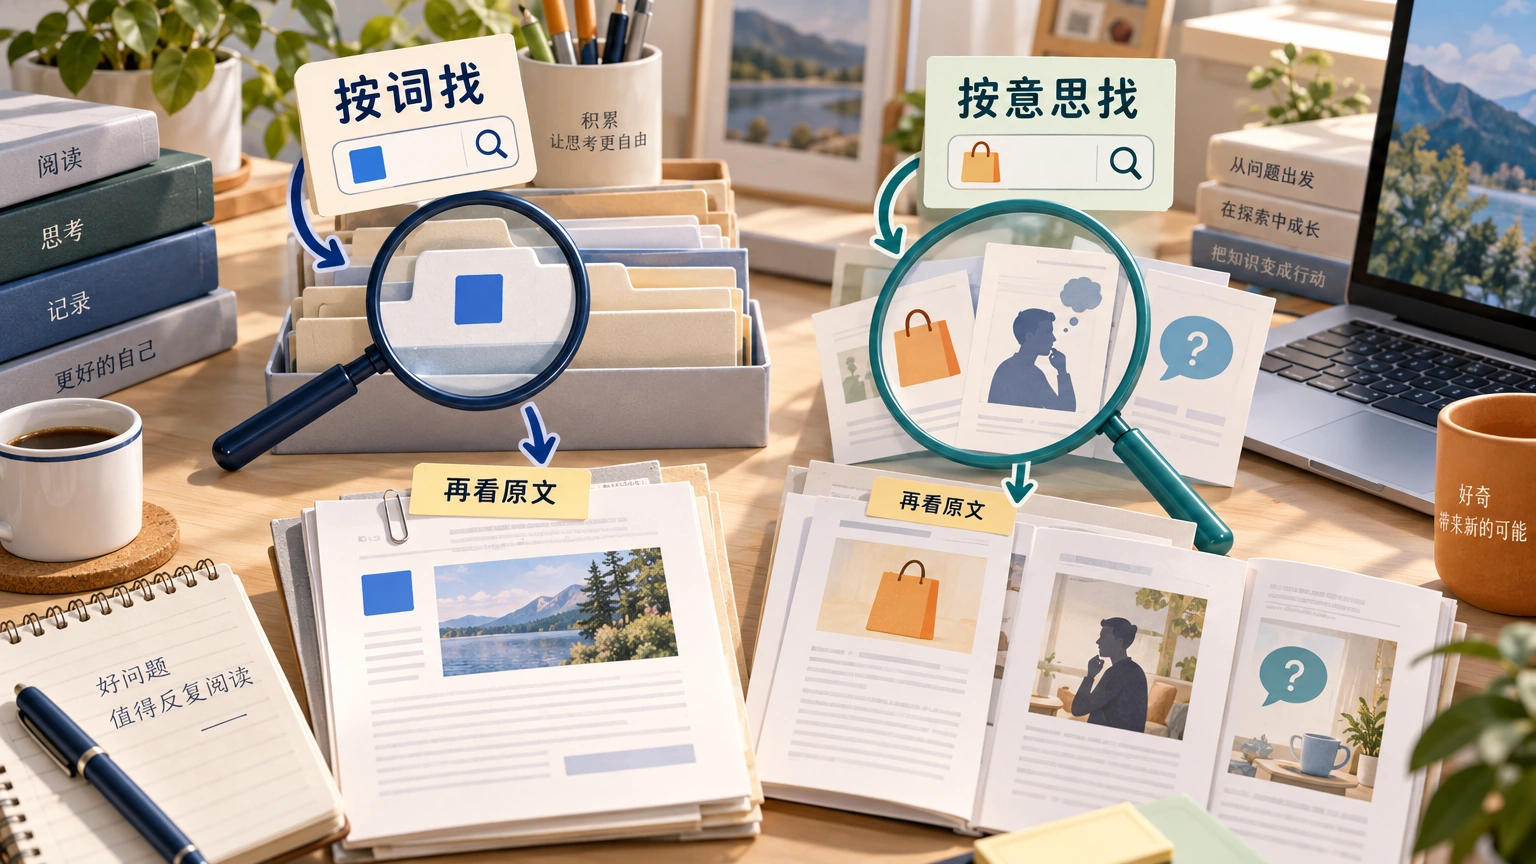
如果我已经知道文件名、型号,或者记得正文里的词,直接搜索当然更省事。全文搜索也可以换词、加同义词、限定目录,我没有把这些办法扔掉。
但是有时候,我只记得想查的主题,不记得文章标题,也不知道作者用了哪个词。比如前面那道题,问题里说的是“越来越迎合人”,原文标题用的却是Sycophancy。这时我就可以直接把问题交给知识库,让它先按内容找相关候选。
我会看自己记得什么,再决定怎么找:
| 我记得什么 | 我会怎么找 |
|---|---|
| 文件名、准确名称或编号 | 通过精确匹配直接找到文件或原文 |
| 正文里出现过的词 | 用全文搜索找到段落,必要时再换词 |
| 只有大概意思 | 用语义检索先找相关候选,再回原文判断 |
语义检索也会找错,所以返回结果以后,我还是要核对原文。它帮我做的是按问题找内容,不是替我保证每份资料都正确、每条旧结论现在仍然适用。
文章、笔记和AI聊天记录,怎么整理成知识库?
我需要查的不只是收藏的文章和笔记,还有保存下来的AI历史聊天、项目背景、讨论过的方案和最后的决定。继续做旧项目时,这些资料能让AI查回之前的讨论和上下文。
我让AI把原始文字保留下来,连同标题、来源和文件位置一起记录。这样找到一段聊天或一条旧决定以后,还能沿着出处回看当时的上下文,核对具体说法。
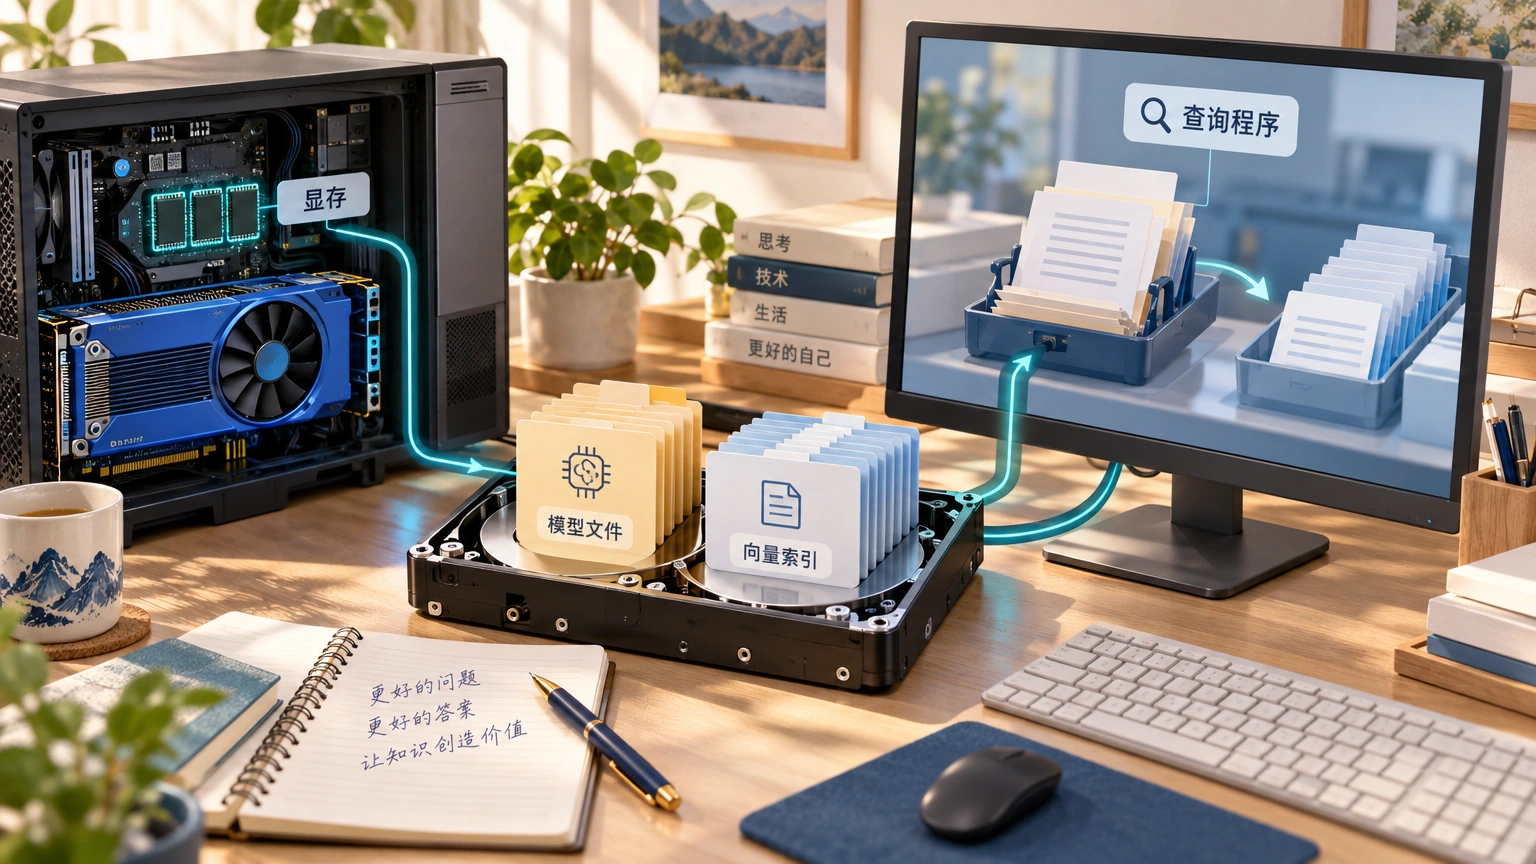
我用的是千问嵌入模型。这里的“嵌入”,可以理解成把文字变成一组用来比较内容的数字,这组数字叫向量。模型先帮查询程序找资料,找到以后,回答和写作仍交给正在使用的AI,不是拿它来替我聊天。
模型通过Ollama在本机运行。AI先把长文或导出的聊天记录拆成小段,相邻两段留一点重叠,再交给模型。每段返回的向量,会跟原文位置一起存进SQLite,也就是一个文件形式的数据库。这些用来查找片段、记住向量和原文位置的记录,就是索引,查询时才能把片段和出处一起带回来。
实际使用时,文章、长期记忆、专题资料和历史会话分别保留自己的索引,AI根据任务调用相应的查询入口。收到任务后,AI先查资料,再打开原文继续处理;新增或修改的文件,也能单独更新。代码、分段和索引处理由AI及工具完成,我提出的是资料怎样被使用、结果怎样核对的要求。
所以查不到时,我会先看文件收进来没有、索引有没有更新,再判断是不是排位的问题。资料如果还没进库,换个大模型也不会凭空找到。
知识库的检索模型,我是怎么选的?
前面说的嵌入模型,负责把问题和资料转成可以比较的向量。选不同的模型,找回资料的结果、电脑占用和建库速度也可能不同,所以搭好检索入口以后,我还要比较模型是否合适。
我用的是千问的嵌入模型,原来用4B,后来换成8B。这是同一系列里两个不同参数规模的版本。
参数是模型在训练中学到的数值。B是billion,也就是十亿;4B和8B是约40亿、80亿这个级别的参数规模叫法,不是“占4GB、8GB内存”。模型文件多大、运行时占多少内存,要分别看实际测量。
4B和8B运行时,各占多少内存?
电脑内存是CPU和程序使用的RAM,显存是显卡使用的内存。我让AI在这台电脑的显卡上运行模型,所以除了电脑内存,还要看模型占了多少显存;下载文件占的则是硬盘空间。
| 运行占用实测 | 4B | 8B |
|---|---|---|
| 电脑内存:Ollama进程工作集合计的采样峰值 | 约1.118 GiB | 约1.288 GiB |
| 显卡显存:模型加载后的驻留量 | 约3.39 GiB | 约5.60 GiB |
| 硬盘:下载后的模型文件 | 约2.50 GB | 约4.68 GB |
这里的GiB是1024进制容量单位,1 GiB=1024 MiB;模型文件沿用下载记录的十进制GB。比如4B这一列,表示模型相关Ollama进程的电脑内存工作集采样峰值约1.118 GiB,模型另驻留约3.39 GiB显存。不是下载2.50 GB文件后,运行也只占2.50 GB。
两个模型的运行记录都显示为全GPU驻留,上表不是纯CPU运行的内存需求,也不是整台电脑的全部占用。Ollama工作集是相关进程的合计,共享页可能重复计数,采样也可能漏过短时尖峰,所以我把它作为运行记录,而不是所有电脑的最低配置。
我用的电脑和相关资料
模型比较记录来自2026年10月24日至25日。
- 显卡是RTX 4070 Ti SUPER,标称16GB显存。系统物理内存约63.8GiB,记录里有20个逻辑处理器,CPU型号和物理核心数没有记录。
- 两模型都是Q4_K_M量化,也就是压缩权重来减少占用;4B是2560维,8B是4096维。
- 固定的是2000个文字片段,不是2000篇独立文章。52题里有26道原题,另外26道换了问法,但仍然沿用原来的目标标注。
- 两模型各自重新编码文档和问题,没有把4B向量直接拿给8B用;对照范围不包含整个生产知识库。
同样问52次,有多少次能找到指定资料?
我让AI用两个模型,分别检索同样的52个问题。每题都事先指定要找哪份资料,查询程序返回一列候选结果,再统计那份资料排在第几条。这里比较的是找资料,不是让模型生成答案。
比如表里的“42次 / 52次(80.8%)”,就是问了52次,其中42次打开第一条结果就能看到指定资料。“查看前5条能找到”则把第1到第5条都算进去:目标排第2条,虽然不算第一条命中,但算前5条找到了。
Hit@1、Hit@3、Hit@5、Hit@10分别是这些口径的指标名。它们是同一批问题的不同查看范围,前5条已经包含前1条和前3条,不能把各行的次数相加。
最后一行MRR@10是另一种汇总名次的分数:目标排第1记1分,第2记0.5分,第3约0.333分,没进前10记0分,再对52题求平均。0.947比0.876高,表示指定资料整体更靠前;它不是94.7%或87.6%的回答正确率。
| 52题总体检索结果 | 4B | 8B |
|---|---|---|
| 只看第1条就找到(Hit@1) | 42次 / 52次(80.8%) | 48次 / 52次(92.3%) |
| 查看前3条能找到(Hit@3) | 48次 / 52次(92.3%) | 50次 / 52次(96.2%) |
| 查看前5条能找到(Hit@5) | 50次 / 52次(96.2%) | 51次 / 52次(98.1%) |
| 查看前10条能找到(Hit@10) | 51次 / 52次(98.1%) | 51次 / 52次(98.1%) |
| 前十平均倒数排名(MRR@10) | 0.876 | 0.947 |
这张表里,8B多了6题排第一,约提高11.5个百分点;但是进入前五只多1题,进入前十则没有变化。它比较的是指定文档的排名,不是AI最后回答得对不对。
比如前面那个4o问题,目标复盘在4B结果里排第二,在8B结果里排第一。4B的第一条是OpenAI后来另一篇同主题复盘,也在谈过度迎合。这一题反映的是指定目标的排序差别,两个模型都找回了相关资料。
同一个意思换种问法,还能找到吗?
52题分成两组:先有26道原问题,再给每题改写一个问法,但仍然找同一份资料。比如后面那道Cursor问题,把“每秒上千token速度编辑文件”改成“快速应用代码修改为什么能那么快”,就是这类改写。
下表的分母因此变成26。“23次 / 26次(88.5%)”表示这一组问了26次,其中23次的指定资料排在第一条。原问题组和改写组分开算,MRR@10仍按前面那种方法计算。
| 分组指标 | 4B | 8B |
|---|---|---|
| 原问题26题:排第一 | 23次 / 26次(88.5%) | 25次 / 26次(96.2%) |
| 原问题26题:进入前五 | 26次 / 26次(100.0%) | 26次 / 26次(100.0%) |
| 原问题26题:MRR@10 | 0.933 | 0.971 |
| 改写问题26题:排第一 | 19次 / 26次(73.1%) | 23次 / 26次(88.5%) |
| 改写问题26题:进入前五 | 24次 / 26次(92.3%) | 25次 / 26次(96.2%) |
| 改写问题26题:MRR@10 | 0.819 | 0.923 |
4B在原题上的前五已经全中,换过问法后,两个模型的结果又不一样。把两组都列出来,能看见这批题里8B改善了哪些位置,也能看见4B原本已经够用的地方。26道改写题仍然不是独立采集的新测试集,不能拿它们推成所有中文问题都会有同样改善。
有一道改写题,从第10排到了第2
这道题要找的是Cursor介绍快速应用代码修改的官方文章。同一轮对照里,原问题和改写后的名次如下:
| 测试时的问法 | 4B名次 | 8B名次 |
|---|---|---|
| 原题:Cursor 是怎么做到每秒上千 token 速度编辑文件的 | 第2 | 第1 |
| 改写:Cursor快速应用代码修改为什么能那么快? | 第10 | 第2 |
这就是“排得更靠前”的一个具体变化:同一目标文档,在这道改写题下从第10到了第2。不过,这只说明这道题的结果,不能把它说成所有任务都有同样效果。
再看为此多用了什么资源
| 资源占用与文字处理速度 | 4B | 8B |
|---|---|---|
| 模型文件,十进制GB | 2.50 | 4.68 |
| 模型驻留显存,GiB | 3.39 | 5.60 |
| 暖态文档编码,片段/秒 | 13.67 | 9.67 |
| 暖态问题编码中位,毫秒 | 57.85 | 62.71 |
| 暖态问题编码P95,毫秒 | 71.56 | 75.38 |
| 每段向量维度 | 2560 | 4096 |
暖态就是模型已经加载。表里的问题编码时间,只算把问题变成向量这一步;后面还要读库、比较和排序,不是几十毫秒就完成了整个知识库查询。P95则用来看较慢那一侧的延迟,也不是最慢的一次。
8B编码文档慢一些,模型文件和驻留显存也更大。向量维度从2560变成4096,同格式原始向量所需空间就是1.6倍,但数据库里还有别的内容,不能说整个库和所有开销都正好翻倍。
文件、显存和运行内存,为什么要分开看?
| 其它采样口径 | 4B | 8B |
|---|---|---|
| Ollama进程工作集采样峰值,GiB | 1.118 | 1.288 |
| 整卡显存采样峰值,GiB | 8.401 | 9.497 |
| 独立测试进程采样峰值,GiB | 0.068 | 0.069 |
模型运行记录显示为全GPU驻留。Ollama进程工作集是当时这条运行路径测到的系统内存,不是只用CPU跑模型的最低要求;整卡显存里也有其它桌面程序的占用,不能再和模型驻留显存相加。
这些峰值是采样值,可能漏掉短时尖峰,运行顺序和其它桌面负载也没有充分随机控制。所以它们用来说明我在这台电脑上实际付出的资源,不是给所有电脑划一条安装门槛。
看完这些,我可以继续用4B,前几条结果已经能找回大部分目标资料,编码更快、占用也小;也可以换8B,接受更大的模型和更慢的文档编码,换取这批题里更靠前的结果。
我选择8B,是因为我的电脑承担得起多出的占用,而这批题的检索又确实有改善。 如果电脑资源紧张,或者看前几条结果已经够用,保留4B完全可以。部分干扰片段由旧4B检索选取,题量也有限,我不会拿这批题的结果替所有中文知识库做决定。
查询程序内存下降,为什么不算8B本身的优势?
AI还调整了查询程序:每次读一批向量,算完再读下一批,不一次把全部向量留在进程里。旧测量约127808片段,进程峰值约4.059GiB;改后的8B查询约126362片段,采样峰值约105.67MiB,完整CLI约3.311秒。
但是两次资料量、程序、模型和峰值记录方法都不同,旧测量还用了已有的问题向量,没有新模型推理。所以这里能说明的是程序写法也影响内存,不能说成“8B比4B省内存”。3.311秒也是当次完整命令的时间,不能和上表的问题编码延迟直接相减。
总结
我搭建本地知识库,是为了让AI能继续使用我保存的文章、笔记、历史聊天和项目记录。资料先整理成可以检索的片段,保留原文和出处;我提出问题以后,AI查相关内容,再回到原文核对,接着处理任务。
知道文件名或原词时,普通搜索仍然好用。只记得大意、说法又和原文不一样时,语义检索能补上另一种找法。找到资料以后,我仍然要看它是否相关,旧结论是否还适用。
模型则按自己的资料和电脑来选。4B在前几条结果里已经能找回大部分目标;我换成8B,是因为电脑承担得起额外占用,而且已有对照里指定资料的排名有改善。资源紧张时保留4B也可以,模型占用的空间和处理资料时的等待,都要放进选择里一起考虑。想自己搭的话,可以先用前面的Prompt,拿少量常用资料跑通查询、原文回读和更新,再决定要不要扩大资料范围或换更大的模型。